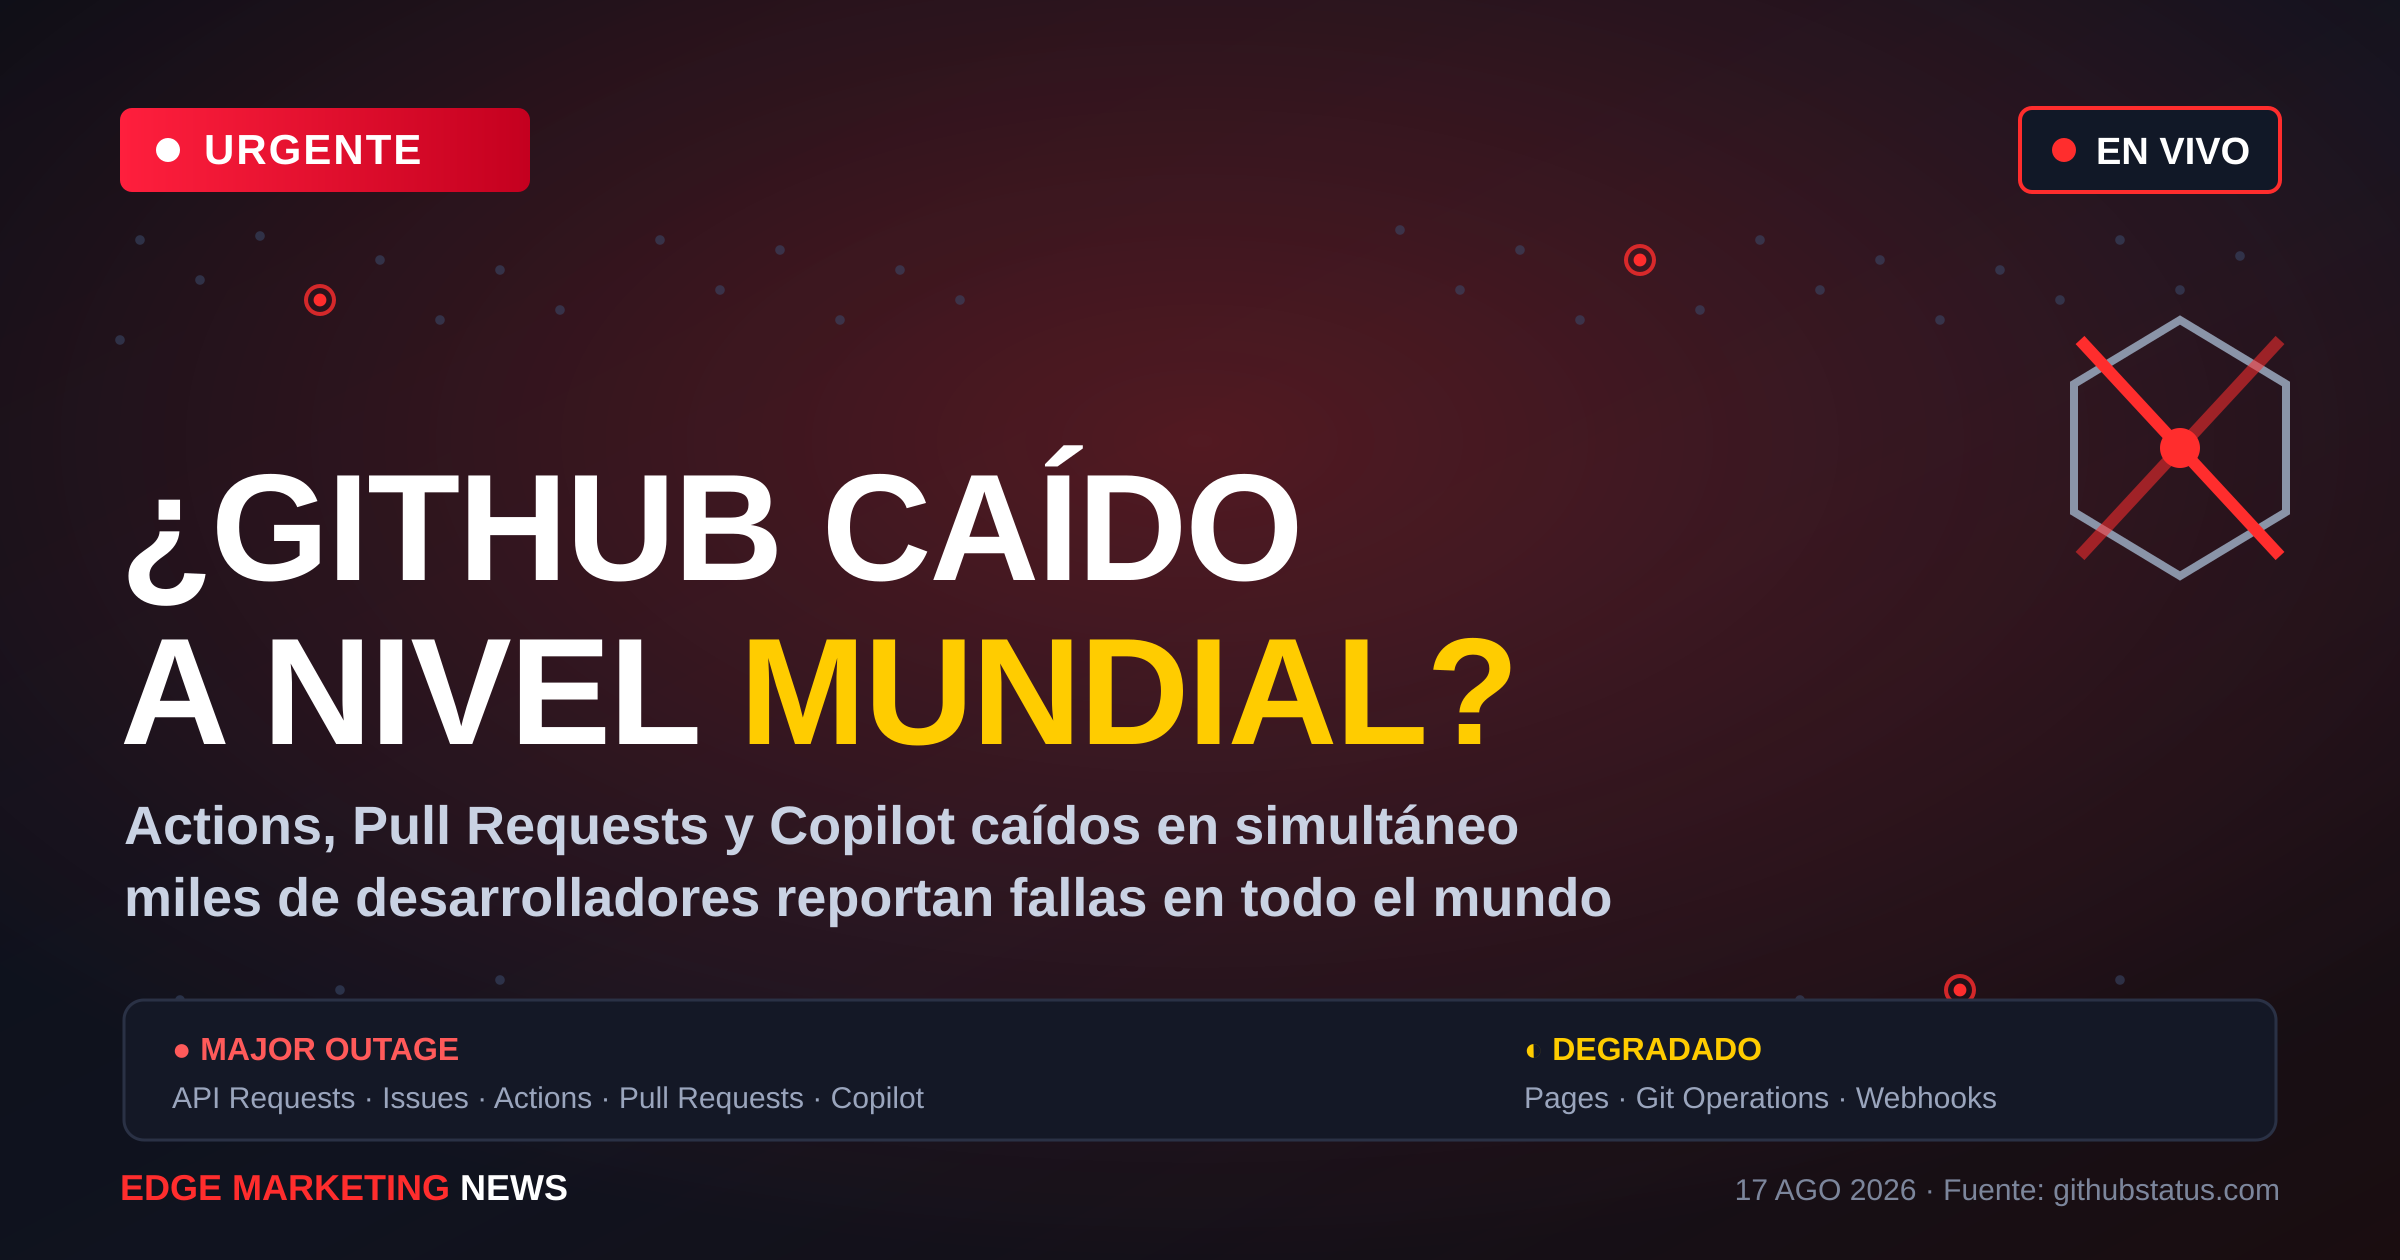
Última hora. Lo que arrancó como quejas sueltas en redes sociales se confirmó minutos después: GitHub, la plataforma que sostiene el código de medio internet, está caída — o al menos gravemente herida — a nivel mundial.
La propia página oficial de estado, githubstatus.com, lo admite en rojo desde las 13:40 UTC de hoy: “Partial System Outage”, con el incidente todavía en estado investigating — es decir, ni GitHub sabe todavía cuándo termina esto.
Lo que está roto ahora mismo
No es un servicio aislado. Según el propio reporte del incidente, hay una caída crítica y simultánea en:
- API Requests — fuera de servicio
- Issues — fuera de servicio
- Actions — fuera de servicio (adiós, pipelines de CI/CD)
- Pull Requests — fuera de servicio
- Copilot — fuera de servicio
Y no termina ahí: Pages, Git Operations y Webhooks están funcionando “a medias”, en estado degradado. GitHub mismo reconoce tasas de error de ~20% en tráfico web y de API, y hasta ~50% de errores al descargar archivos o repositorios completos.
Traducido: si hoy tu git push se quedó colgado, si Copilot dejó de autocompletar a mitad de frase, o si un pipeline de Actions no arrancó — no es tu conexión. Es GitHub.
¿Por qué asusta tanto?
Porque GitHub no es “una app más”. Es la columna vertebral de cómo se construye software en el mundo entero: desde el equipo de una startup en Quito hasta las actualizaciones de sistemas críticos de bancos y gobiernos pasan, en algún punto de la cadena, por GitHub. Cuando GitHub tose, miles de equipos de desarrollo — y sus lanzamientos, sus builds, sus deploys de hoy — se quedan literalmente parados.
Para dimensionar la magnitud: GitHub aloja más de 200 millones de repositorios y es usado por más de 100 millones de desarrolladores en todo el mundo. Empresas como Microsoft, Google, Amazon, Netflix y prácticamente cada startup tecnológica del planeta dependen de GitHub para su flujo de trabajo diario. Cuando la plataforma cae, el impacto no es solo “no puedo hacer push” — es que las actualizaciones de seguridad no se distribuyen, los pipelines de deploy no ejecutan, las revisiones de código se estancan y los releases planificados para hoy se posponen indefinidamente.
Impacto real: qué se detuvo cuando GitHub cayó
La interrupción no es abstracta. Hay impactos concretos que afectan a equipos y empresas en todo el mundo:
Pipelines de CI/CD detenidos. GitHub Actions es el motor detrás de miles de pipelines de integración continua y despliegue continuo. Cuando Actions cae, los equipos no pueden ejecutar tests automatizados, generar builds de producción ni deployar nuevas versiones. Para empresas que practican despliegues diarios o incluso múltiples veces al día, esto significa que el código nuevo se acumula sin poder liberarse.
Pull Requests bloqueados. Las revisiones de código — el proceso por el cual un desarrollador revisa el trabajo de otro antes de fusionarlo — dependen de Pull Requests. Sin PRs, el flujo de trabajo de desarrollo se detiene. Los equipos que dependen de revisiones de código como gate de calidad no pueden avanzar.
Copilot inutilizable. Para los miles de desarrolladores que incorporaron Copilot en su flujo de trabajo diario, perder la herramienta de IA es como perder un asistente que reduce significativamente el tiempo de tareas repetitivas. No es crítico para la supervivencia del proyecto, pero sí impacta la productividad diaria de forma medible.
Issues y documentación inaccesibles. Los repositorios que usan Issues de GitHub como sistema de seguimiento de bugs y features pierden visibilidad sobre su backlog. Los equipos de soporte que responden Issues públicas no pueden acceder a la información.
Pages fuera de servicio. Miles de sitios web estáticos alojados en GitHub Pages se caen simultáneamente — documentación de proyectos, portafolios, blogs técnicos y hasta landing pages de startups.
¿Qué dice GitHub?
Por ahora, poco y con cautela: reconocen el problema, dicen estar “realizando mitigaciones” y prometen actualizaciones a medida que avancen. No hay, todavía, una causa raíz confirmada ni una hora estimada de resolución.
La falta de comunicación detallada es, en sí misma, un problema. Los equipos de desarrollo necesitan saber no solo que hay un incidente, sino: ¿cuál es el alcance exacto? ¿Qué servicios están afectados y cuáles no? ¿Hay data loss o solo degradación de servicio? ¿Cuál es la causa probable? Cada minuto sin información es un minuto en el que los equipos toman decisiones sin datos — y muchas de esas decisiones (cambiar temporalmente a GitLab, pausar releases, notificar a clientes) tienen un costo real.
¿Qué hacer mientras tanto?
Si trabajas con GitHub hoy, aquí van recomendaciones concretas:
1. Guarda tu trabajo en local. Si estabas a punto de hacer push, haz un commit local y guardselo. No pierdas trabajo pendiente por si el incidente se extiende.
2. Evita depender de Actions para nada urgente. Si tienes un pipeline que debe ejecutarse hoy para un release, considera ejecutar los tests manualmente en local o en otra plataforma temporalmente.
3. Ten paciencia con Copilot. Si Copilot dejó de funcionar, no es un problema de licencia — es parte del incidente. Volverá cuando GitHub restaure el servicio.
4. Comunica con tu equipo. Si trabajas en equipo, avisa que los retrasos en deploys o revisiones son por el incidente de GitHub, no por falta de producción.
5. No intentes reposicionar o migrar en caliente. La tentación de migrar a GitLab o Bitbucket durante un outage es comprensible, pero hacerlo bajo presión y sin planificación suele crear más problemas de los que resuelve. Evalúa eso con calma después de que GitHub se recupere.
6. Monitorea la página de estado. githubstatus.com se actualiza con cada cambio en el estado de los servicios. Refresca cada 15-20 minutos para estar al tanto.
El debate de fondo: dependencia de un solo proveedor
Este incidente reaviva una conversación que el mundo del desarrollo lleva años teniendo: ¿es sano que tanta infraestructura crítica de software dependa de una sola plataforma? GitHub, que pertenece a Microsoft desde 2018, es aujourdías el estándar de facto para hosting de código fuente. Pero la concentración crea un riesgo sistémico: cuando GitHub cae, cae el ecosistema entero de desarrollo de software a nivel mundial.
Las alternativas existen — GitLab, Bitbucket, Codeberg — pero la inercia es enorme. Migrar un repositorio es relativamente sencillo; migrar la cultura de trabajo de un equipo (issues, PRs, Actions, Copilot) es otro tema. Y sin una alternativa que ofrezca el mismo nivel de integración y ecosistema, muchas empresas simplemente absorben el costo de los outages y esperan.
La lección para las empresas ecuatorianas es clara: si tu negocio depende de herramientas de desarrollo alojadas en la nube, necesitas un plan B documentado. No tiene que ser una migración completa — puede ser simplemente saber cómo ejecutar tus pipelines críticos manualmente o tener un espejo del código en otra plataforma para emergencias.
Incidentes anteriores de GitHub
Este no es el primer outage significativo de GitHub. La plataforma ha tenido varios incidentes notables en los últimos años:
- 2021: un ataque DDoS afectó el acceso a GitHub durante varias horas.
- 2023: una interrupción de 4 horas dejó a millones de desarrolladores sin acceso a repositorios y PRs.
- 2024: un problema con la autenticación impedía el acceso a repositorios privados durante el periodo laboral de Asia y Europa.
Cada incidente refuerza la misma lección: la disponibilidad no es garantía, y los equipos deben diseñar sus flujos de trabajo asumiendo que las herramientas pueden fallar.
Actualización del incidente
Esta nota se actualizará cuando GitHub confirme la resolución del incidente y proporcione una causa raíz. Si necesitas información en tiempo real, consulta directamente githubstatus.com.
Fuente: githubstatus.com — incidente activo al momento de esta publicación.